Myndbandagreining er að færast frá leitarorðum yfir í merkingu, Hér er hvað það þýðir
Myndbandagreining (video intelligence) þýddi áður fyrr að lesa titla og merki. Núna er breytingin sú að lesa myndbandið sjálft, talið, senurnar og merkinguna, áður en þú skrifar nokkur lýsigögn. Hér er hvernig merkingar-fyrst greining virkar.
By VidSeeds.ai Team
Myndbandagreining (video intelligence) snýst um að láta hugbúnað skilja myndband í raun og veru, hvað er sagt, hvað er sýnt og um hvað það snýst, í stað þess að giska út frá titlinum og merkjunum (tags) sem fylgja því. Breytingin sem á sér stað núna er frá síðarnefndu aðferðinni yfir í þá fyrri: verkfæri áður fyrr lásu lýsigögnin (metadata), en eru nú að færast yfir í að lesa sjálft myndbandið. Þetta skiptir máli vegna þess að YouTube hlustar þegar á töluðu orðin þín og fylgist með hvað áhorfendur gera eftir að þeir smella, þannig að umbúðirnar sem virka eru þær umbúðir sem passa heiðarlega við myndbandið sjálft.
Ég rek rússneska náttúrurás og í mörg ár fínstillti ég upphöndlun á gamla mátann, valdi leitarorð, beygði titilinn í kringum það og vonaði að hann myndi raðast ofarlega. Sú hæga lexía sem ég lærði var að leitarorðaleikirnir breyttu nánast engu, og vinnan sem raunverulega jók áhorf var af leiðinlegu gerðinni: að láta titilinn lýsa því á heiðarlegan hátt sem var í myndbandinu. Það er það sem „merkingar-fyrst“ (meaning-first) snýst um. Þetta er minna spurning um snjallt trikk og meira um strangari kröfur.
Hvað er myndbandagreining?
Myndbandagreining er hugbúnaðargreining á raunverulegu innihaldi myndbands, afriti af því sem er sagt, senunum á skjánum, tilfinningalegu flæði og þeim boðskap sem verið er að koma á framfæri. Leitarorðaverkfæri les textann í kringum myndband. Merkingar-fyrst tól les myndbandið sjálft. Munurinn kemur í ljós um leið og umbúðirnar og innihaldið stangast á: leitarorðagreining getur ekki greint þetta ósamræmi vegna þess að hún leit aldrei inn í myndbandið, á meðan innihaldsgreining byrjar þar.
Flest eldri verkfæri fyrir efnishöfunda, þau sem gefa titlinum þínum einkunn og telja merkin þín, vinna eingöngu út frá lýsigögnum. Þau eru gagnleg fyrir fljótlegt tékk, en þau eru að lýsa miðanum á dósinni, ekki innihaldinu. Nýrri nálgunin lítur á myndbandið sjálft sem uppsprettu sannleikans og lýsigögnin sem lýsingu sem þarf að standa undir sér.
Hvernig skilur gervigreind merkingu myndbands?
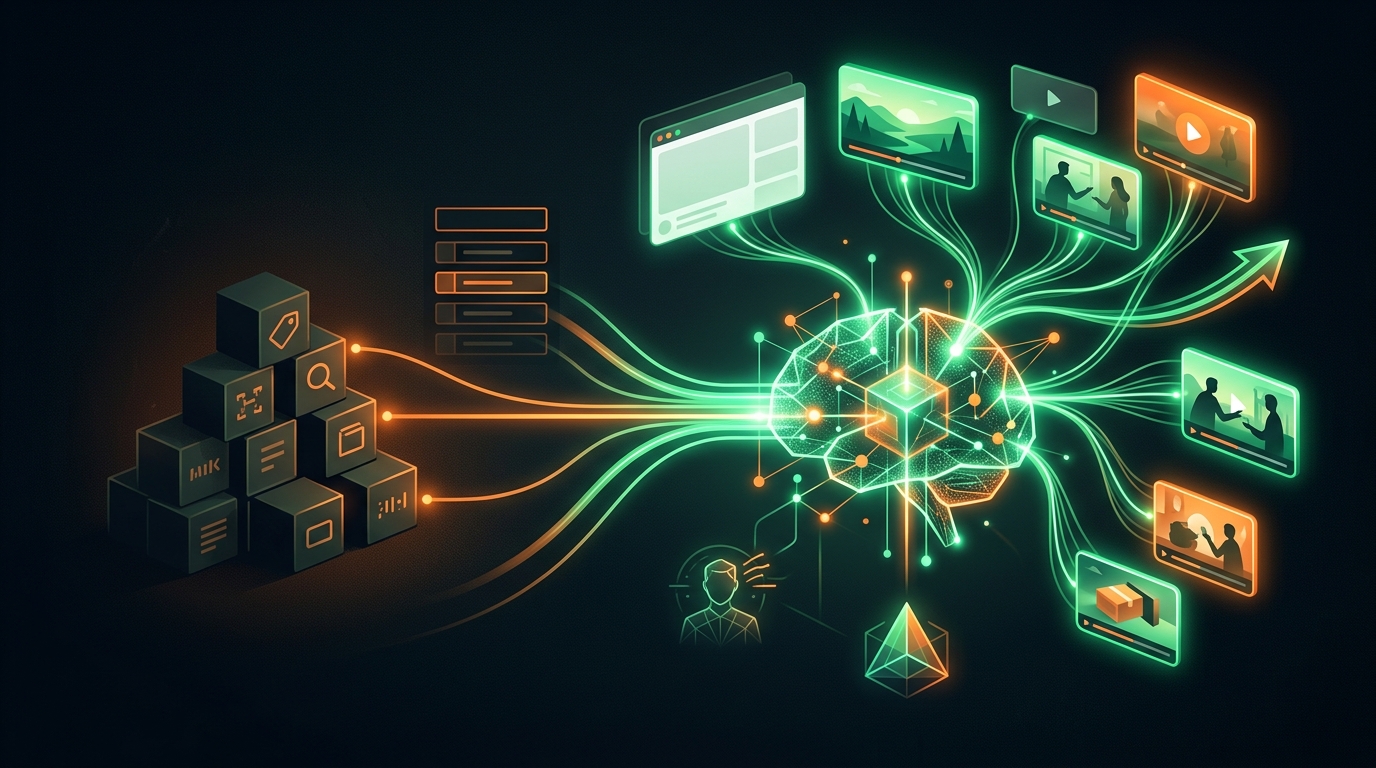
Hún les myndbandið eins og mörg skilningarvit myndu gera í einu: hún skrifar upp talið, skoðar rammanna og tekur eftir því hvar orkan rís og hnígur. Þetta er venjulega kallað fjölþætt greining (multimodal analysis), „fjölþætt“ þýðir einfaldlega að hún notar fleiri en eina upplýsingaleið (hljóðið, myndina og tímasetninguna), en ekki bara orðin. Út frá þessum merkjum byggir hún upp mynd af því hvað myndbandið er: spurningunni sem það svarar, augnablikinu sem það byggir upp að, og fyrir hvern það er.
Nokkrir áþreifanlegir hlutir sem þessi greining skilar, með því að vinna út frá innihaldinu frekar en leitarorðalista:
Afrit með tímastimplum. Að vita hvenær eitthvað er sagt er það sem gerir tólum kleift að stinga upp á heiðarlegum köflum (chapters) og velja rétta klippu, í stað þess að búa til uppbyggingu sem myndbandið hefur ekki.
Tilfinningalega formið. Flest myndbönd hafa hápunkt, afhjúpunina, brandarann, vendipunktinn, og að finna hvar hann liggur hjálpar þér að skrifa titil og velja smámynd (thumbnail) sem vísar á raunverulega augnablikið í stað almenns ramma.
Raunverulega viðfangsefnið. Ekki frasinn sem þú vonaðist til að raðast á, heldur það sem myndbandið fjallar raunverulega um. Það er grunnurinn sem titillinn, lýsingin og merkin eru byggð á, svo þau passi við það sem áhorfandi mun sjá.
Af hverju er leitarorðasamsvörun ekki lengur nóg?
Vegna þess að YouTube gefur þér einkunn út frá því sem gerist eftir að smellt er, og leitarorðasamsvörun sér ekki svo langt. Þú getur raðast ofarlega fyrir hugtak sem passar ekki við myndbandið þitt, en fólkið sem það laðar að fer á fyrstu sekúndunum, og þessi snemma brottför er það merki sem YouTube treystir best. Leitarorð sem þú „vinnur“ með myndbandi sem passar ekki er verra en ekkert leitarorð.
Merki (tags) eru skýrasta dæmið. YouTube hefur sagt í mörg ár að merki spili mjög lítið hlutverk í því að fólk finni myndbönd, og það hefur ekki breyst, töluðu orðin þín, titillinn og lýsingin vinna erfiðisvinnuna. Þannig að tól sem aðallega telur og gefur merkjum einkunn er að fínstilla þann hluta sem skiptir varla máli. Merkingar-fyrst greining eyðir athygli sinni í þann hluta sem skiptir máli: að passa heiðarlegar umbúðir við raunverulegt innihald, svo áhorfendurnir sem koma séu þeir sem staldra við.
Það eru takmörk sem vert er að taka fram skýrt. Ekkert af þessu bjargar myndbandi sem enginn vill horfa á. Að skilja merkingu myndbands hjálpar rétta fólkinu að finna gott myndband hraðar; það gerir lélegt myndband ekki gott. Að vera heiðarlegur um það er hluti af því hvers vegna þessi nálgun heldur velli.
Hvar passar VidSeeds.ai inn í merkingar-fyrst myndbandagreiningu?
VidSeeds.ai greinir myndbandið sjálft áður en þú hleður því upp, talið, senurnar, tilfinningalegu flæðin, merkinguna, og býr til drög að titlum, lýsingu með tímastimplum, merkjum, köflum og smámynd sem byggir á því sem raunverulega er í myndbandinu. Það gerir þetta fyrir YouTube og, ef þú birtir þar líka, TikTok, Instagram, Facebook, LinkedIn og X, á 85 tungumálum. Fjölþætt greining er sá hluti sem les innihaldið fyrst; smámyndarammar sem hún stingur upp á koma úr þínu eigin myndbandi, svo andlitið og augnablikið eru raunveruleg.
Þú yfirferð og ritstýrir öllu áður en nokkuð er birt, ekkert fer í loftið án þíns samþykkis. Það býr ekki til eða klippir myndbandið þitt, og það mun ekki finna upp krækju (hook) sem myndbandið getur ekki staðið undir. Þetta er sjálfstæður valkostur við vidIQ og TubeBuddy, með þeim eina mun að það les myndbandið sjálft áður en það skrifar eitt einasta orð af lýsigögnum. Þú getur byrjað ókeypis með 30 Seeds, án greiðslukorts.
Algengar spurningar
Hvað er myndbandagreining?
Myndbandagreining er hugbúnaðargreining á raunverulegu innihaldi myndbands, afriti af því sem er sagt, senunum á skjánum, tilfinningalegu flæði og boðskapnum sem verið er að koma á framfæri, frekar en bara titlinum, lýsingunni og merkjunum í kringum það. Merkingar-fyrst myndbandagreining byrjar á myndbandinu og lítur á lýsigögnin sem eitthvað sem verður að passa heiðarlega við það.
Hver er munurinn á leitarorðaverkfærum og merkingar-fyrst greiningu?
Leitarorðaverkfæri lesa textann í kringum myndband og gefa honum einkunn; merkingar-fyrst greining les myndbandið sjálft. Munurinn kemur í ljós þegar umbúðir og innihald stangast á, leitarorðagreining getur ekki greint þetta ósamræmi vegna þess að hún leit aldrei inn í myndbandið, á meðan innihaldsgreining byrjar þar.
Hvað þýðir fjölþætt greining (multimodal analysis)?
Fjölþætt greining notar fleiri en eina upplýsingaleið úr myndbandi í einu, hljóðið (tal), myndina (senur) og tímasetningu tilfinningalegra hápunkta, í stað þess að skoða eingöngu orðin. Með því að sameina þessi merki getur tól skilið um hvað myndbandið snýst raunverulega, en ekki bara hvernig það er merkt.
Býr VidSeeds.ai til myndbönd?
Nei. VidSeeds.ai greinir myndband sem þú ert þegar með, áður en því er hlaðið upp, og útbýr drög að lýsigögnum og smámynd sem passa við innihald þess svo þú getir samþykkt það. Það býr ekki til, ritstýrir eða hýsir myndbönd, og sjálfvirkar klippur eru teknar úr þínu eigin myndbandi, ekki búnar til frá grunni.
Skiptir leitarorðafínstilling enn máli á YouTube?
Svolítið, og aðeins til að passa við rétta leit. Settu frasann sem áhorfandi myndi raunverulega skrifa nálægt byrjun titilsins og einu sinni í lýsinguna, og láttu þar við sitja. YouTube vigtar merki (tags) mjög lítið og dæmir þig aðallega á áhorfstíma (retention), þannig að heiðarlegar umbúðir sem passa við myndbandið skipta mun meira máli en þéttleiki leitarorða.