Video-intelligens bevæger sig fra søgeord til betydning, her er, hvad det betyder
Video-intelligens betød tidligere at læse titler og tags. Skiftet nu går mod at læse selve videoen, talen, scenerne og betydningen, før du skriver nogen metadata. Her er, hvordan betydningsførst-analyse fungerer.
Af VidSeeds.ai Team
Video-intelligens er praksissen med at lade software rent faktisk forstå en video, hvad den siger, hvad den viser, og hvad den handler om, i stedet for at gætte ud fra den titel og de tags, der er pakket udenom den. Det skift, der sker lige nu, går fra den sidstnævnte type til den første: Værktøjer plejede at læse metadata, og nu bevæger de sig mod at læse selve videomaterialet. Det betyder noget, fordi YouTube allerede lytter til dine talte ord og holder øje med, hvad seerne gør, efter de har klikket. Derfor er den emballage, der performer, den emballage, der ærligt matcher videoen nedenunder.
Jeg driver en russisk naturkanal, og i årevis optimerede jeg uploads på den gamle måde, vælg et søgeord, bøj titlen udenom det, og håb på, at den rangerer. Den langsomme lektie var, at søgeordslegene stort set intet rykkede, og det arbejde, der rent faktisk skabte visninger, var den kedelige slags: at få titlen til ærligt at beskrive, hvad der var i videoen. Det er det, "betydningsførst" (meaning-first) handler om. Det er mindre et smart trick og mere en strengere standard.
Hvad er video-intelligens?
Video-intelligens er softwareanalyse af en videos reelle indhold, transskriptionen af, hvad der bliver sagt, scenerne på skærmen, de følelsesmæssige højdepunkter og den pointe, det hele bygger op til. Et søgeordsværktøj læser teksten omkring en video. Et betydningsførst-værktøj læser selve videoen. Forskellen viser sig i det øjeblik, din emballage og dit indhold er uenige: Søgeordsanalyse kan ikke fange det misforhold, fordi den aldrig kiggede indeni, mens indholdsanalysen starter der.
De fleste ældre creator-værktøjer, dem, der bedømmer din titel og tæller dine tags, arbejder udelukkende ud fra metadata. De er nyttige til et hurtigt tjek, men de beskriver mærkaten på dåsen, ikke indholdet. Den nyere tilgang behandler videomaterialet som kilden til sandhed og metadataene som en beskrivelse, der skal gøre sig fortjent til det.
Hvordan forstår AI en videos betydning?
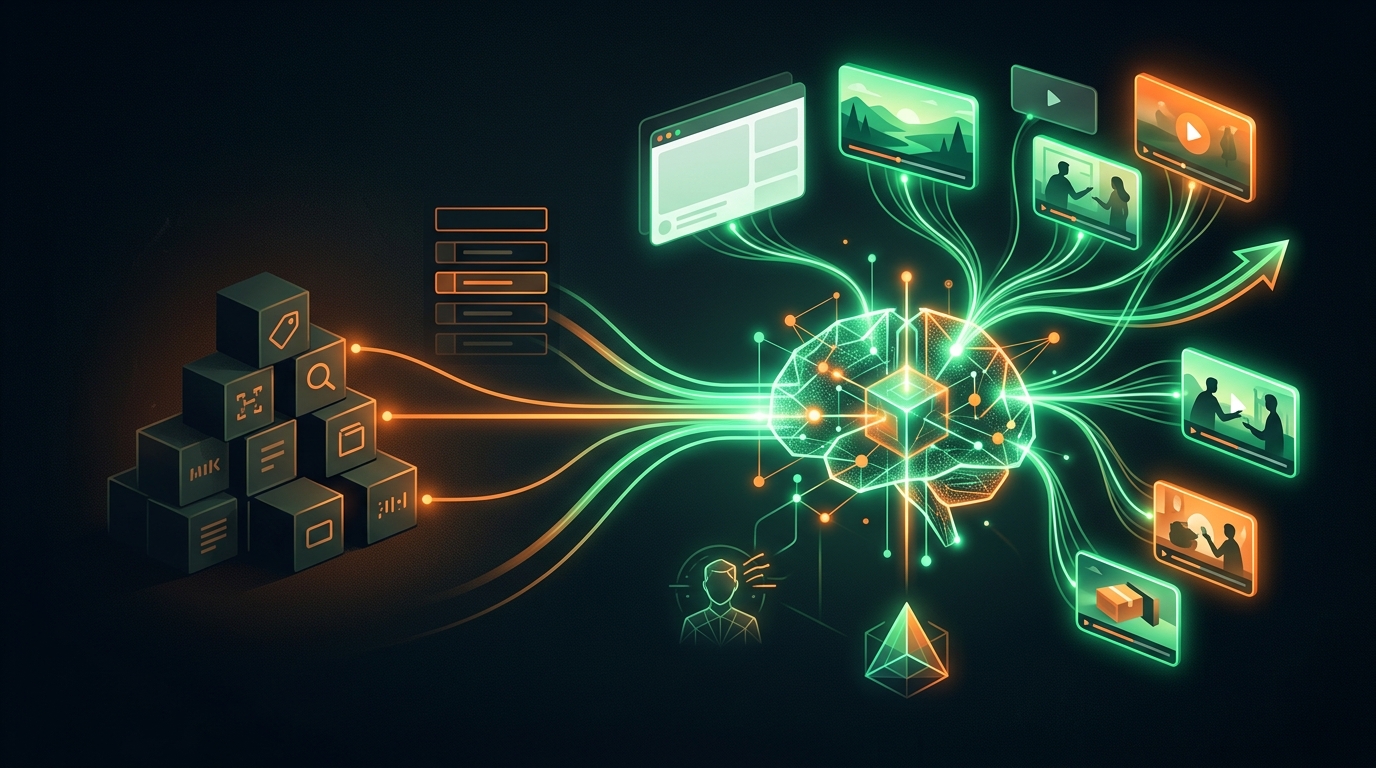
Den læser videoen på samme måde, som flere sanser ville gøre på én gang: Den transskriberer talen, kigger på billederne og bemærker, hvor energien stiger og falder. Dette kaldes normalt multimodal analyse, "multimodal" betyder blot, at den bruger mere end én informationskanal (lyden, billedet og timingen) og ikke kun ordene. Ud fra disse signaler opbygger den et billede af, hvad videoen er: det spørgsmål, den besvarer, det øjeblik, den bygger op til, og hvem den er henvendt til.
Her er et par konkrete ting, som denne analyse producerer, når den arbejder ud fra indholdet i stedet for en søgeordsliste:
En transskription med tidsstempler. At vide, hvornår noget bliver sagt, er det, der gør det muligt for et værktøj at foreslå ærlige kapitler og udvælge det helt rigtige klip i stedet for at opfinde en struktur, som videomaterialet ikke har.
Den følelsesmæssige kurve. De fleste videoer har et højdepunkt, afsløringen, joken, vendepunktet, og ved at finde ud af, hvor det lander, kan du skrive en titel og vælge et thumbnail-billede, der peger på det reelle øjeblik i stedet for et generisk et.
Det faktiske emne. Ikke den sætning, du håbede på at rangere på, men det, videoen reelt handler om. Det er det fundament, som titlen, beskrivelsen og tags bliver bygget på, så de matcher det, en seer faktisk vil opleve.
Hvorfor er søgeordsmatchning ikke længere nok?
Fordi YouTube bedømmer dig på, hvad der sker efter klikket, og søgeordsmatchning kan ikke se så langt. Du kan godt rangere på et udtryk, der ikke passer til din video, men de mennesker, det tiltrækker, smutter igen i løbet af de første par sekunder, og den tidlige exit er det signal, YouTube stoler allermest på. Et søgeord, du "vinder" med en video, der ikke matcher, er værre end slet intet søgeord.
Tags er det tydeligste eksempel. YouTube har i årevis sagt, at tags spiller en meget lille rolle for, hvordan videoer bliver fundet, og det har ikke ændret sig, dine talte ord, titel og beskrivelse gør det tunge arbejde. Så et værktøj, der primært tæller og bedømmer tags, optimerer den del, der næsten ikke tæller. Betydningsførst-analyse bruger sin opmærksomhed på den del, der faktisk betyder noget: at matche ærlig emballage med reelt indhold, så de seere, der ankommer, også er dem, der bliver hængende.
Der er en grænse, som er værd at sige ligeud. Intet af dette redder en video, som ingen har lyst til at se. At forstå en videos betydning hjælper de rigtige mennesker med at finde en god video hurtigere; det gør ikke en svag video god. At være ærlig omkring det er en del af grunden til, at denne tilgang holder.
Hvor passer VidSeeds.ai ind i betydningsførst-video-intelligens?
VidSeeds.ai analyserer selve videoen, før du uploader, talen, scenerne, de følelsesmæssige højdepunkter, betydningen, og udarbejder derefter udkast til titler, en beskrivelse med tidsstempler, tags, kapitler og et thumbnail, der er forankret i, hvad der faktisk er i videomaterialet. Det gør den for YouTube og, hvis du også udgiver der, TikTok, Instagram, Facebook, LinkedIn og X, på 85 sprog. Den multimodale analyse er den del, der læser indholdet først; de thumbnail-billeder, den foreslår, kommer fra din egen video, så ansigtet og øjeblikket er ægte.
Du gennemser og redigerer alt, før noget udgives, intet går live uden dit samtykke. Den genererer eller redigerer ikke din video, og den opfinder ikke et "hook", som videomaterialet ikke kan leve op til. Det er et uafhængigt alternativ til vidIQ og TubeBuddy, med den ene forskel, at det læser selve videoen, før det skriver et eneste ord af dine metadata. Du kan starte gratis med 30 Seeds, uden kort.
Ofte stillede spørgsmål
Hvad er video-intelligens?
Video-intelligens er softwareanalyse af en videos reelle indhold, transskriptionen af, hvad der bliver sagt, scenerne på skærmen, de følelsesmæssige højdepunkter og den pointe, der bliver lavet, i stedet for blot titlen, beskrivelsen og de tags, der ligger udenom. Betydningsførst-video-intelligens starter fra videomaterialet og behandler metadataene som noget, der ærligt skal matche det.
Hvad er forskellen på søgeordsværktøjer og betydningsførst-analyse?
Søgeordsværktøjer læser teksten, der er pakket udenom en video, og bedømmer den; betydningsførst-analyse læser selve videoen. Forskellen viser sig, når emballage og indhold er uenige, søgeordsanalyse kan ikke fange det misforhold, fordi den aldrig kiggede indeni videoen, mens indholdsanalysen begynder der.
Hvad betyder multimodal analyse?
Multimodal analyse bruger mere end én informationskanal fra en video på samme tid, lyden (talen), billedet (scenerne) og timingen af de følelsesmæssige højdepunkter, i stedet for kun ordene. Ved at kombinere disse signaler kan et værktøj forstå, hvad en video reelt handler om, og ikke kun, hvad den er mærket som.
Genererer VidSeeds.ai videoer?
Nej. VidSeeds.ai analyserer en video, du allerede har, før du uploader, og udarbejder metadata og et thumbnail, der matcher indholdet, som du derefter kan godkende. Den genererer, redigerer eller hoster ikke video, og auto-klip udtrækkes fra dit eksisterende videomateriale, de bliver ikke skabt fra bunden.
Betyder søgeordsoptimering stadig noget på YouTube?
En smule, og kun for at matche den rigtige søgning. Placer den sætning, en seer faktisk ville skrive, tæt på starten af din titel og én gang i din beskrivelse, og stop så der. YouTube vægter tags meget lavt og bedømmer dig primært på fastholdelse (retention), så ærlig emballage, der passer til videoen, betyder langt mere end søgeordstæthed.