A videó-intelligencia a kulcsszavaktól a jelentés felé mozdul el, Íme, mit jelent ez
A videó-intelligencia korábban a címek és címkék olvasását jelentette. A hangsúly most magának a videónak, a beszédnek, a jeleneteknek és a jelentésnek, a beolvasására helyeződik át, még a metaadatok megírása előtt. Íme, hogyan működik a jelentésközpontú elemzés.
Szerző VidSeeds.ai Team
A videó-intelligencia (video intelligence) az a gyakorlat, amikor a szoftver valóban megérti a videót, amit mond, amit mutat, és amiről szól, ahelyett, hogy a köré épített címből és címkékből találgatna. A most zajló változás az utóbbitól az előbbi felé mutat: a korábbi eszközök a metaadatokat olvasták, az újak viszont már magát a felvételt elemzik. Ez azért fontos, mert a YouTube már most is hallgatja az elhangzott szavakat, és figyeli, mit tesznek a nézők a kattintás után, így az a csomagolás működik jól, amelyik őszintén illeszkedik a mögötte lévő videóhoz.
Egy orosz természetcsatornát vezetek, és évekig a régi módszerrel optimalizáltam a feltöltéseket, kiválasztottam egy kulcsszót, köré hajlítottam a címet, és reméltem, hogy rangsorolást kapok. A lassan megtanult lecke az volt, hogy a kulcsszójátékok alig mozdítottak el valamit, és az a munka hozott valódi nézettséget, ami a legunalmasabb volt: elérni, hogy a cím őszintén leírja, mi van a videóban. Erről szól a „jelentésközpontú” (meaning-first) megközelítés. Ez kevésbé egy okos trükk, mint inkább egy szigorúbb mérce.
Mi az a videó-intelligencia?
A videó-intelligencia a videó valós tartalmának szoftveres elemzése, az elhangzottak leirata, a képernyőn látható jelenetek, az érzelmi csúcspontok és az a lényeg, amit az egész videó át akar adni. Egy kulcsszó-eszköz a videó körüli szöveget olvassa. Egy jelentésközpontú eszköz magát a videót olvassa. A különbség abban a pillanatban megmutatkozik, amikor a csomagolás és a tartalom nem egyezik: a kulcsszó-elemzés nem tudja kiszúrni ezt az eltérést, mert soha nem nézett bele a videóba, míg a tartalomelemzés pontosan ott kezdődik.
A legtöbb hagyományos tartalomkészítő eszköz, azok, amelyek osztályozzák a címedet és számolják a címkéidet, teljesen a metaadatokból dolgozik. Hasznosak egy gyors ellenőrzésre, de a konzerven lévő címkét írják le, nem a tartalmát. Az újabb megközelítés a felvételt tekinti az igazság forrásának, a metaadatokat pedig egy olyan leírásnak, amelynek meg kell felelnie ennek az igazságnak.
Hogyan érti meg az AI egy videó jelentését?
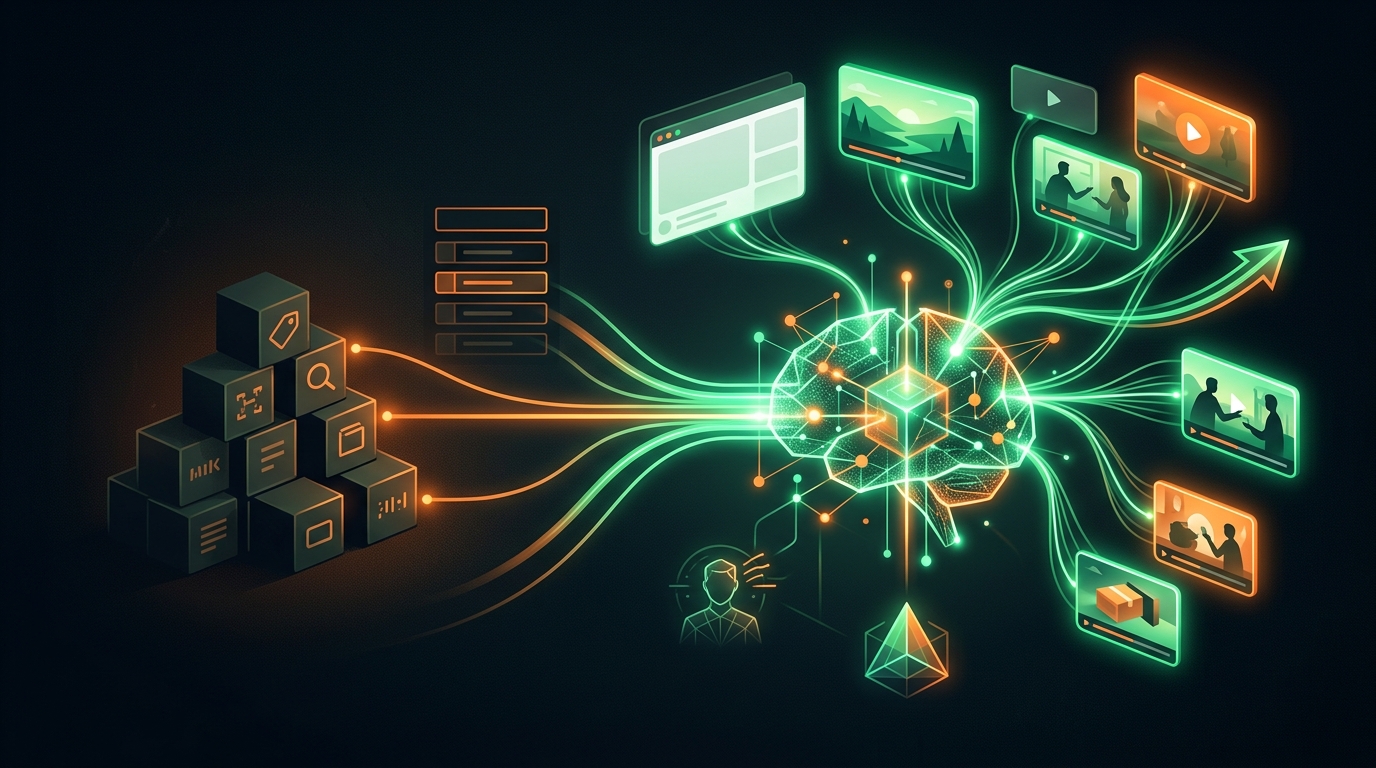
Úgy olvassa a videót, ahogyan azt több érzékszervvel egyszerre tennénk: leírja a beszédet, elemzi a képkockákat, és feljegyzi, hol emelkedik és esik az energia. Ezt általában multimodális elemzésnek (multimodal analysis) nevezik, a „multimodális” egyszerűen azt jelenti, hogy egynél több információs csatornát használ (a hangot, a képet és az időzítést), nem csak a szavakat. Ezen jelek alapján épít fel egy képet arról, hogy mi is a videó: milyen kérdésre válaszol, milyen pillanat felé építkezik, és kiknek szól.
Néhány konkrét dolog, amit ez az elemzés produkál, a tartalomra és nem egy kulcsszólistára támaszkodva:
Időkódolt leirat. Annak ismerete, hogy mikor hangzik el valami, lehetővé teszi a szoftver számára, hogy hiteles fejezeteket javasoljon és a megfelelő klipet vágja ki, ahelyett, hogy olyan struktúrát találna ki, amellyel a felvétel valójában nem rendelkezik.
Az érzelmi ív. A legtöbb videónak van egy csúcspontja, a leleplezés, a poén, a fordulat, és ennek megtalálása segít olyan címet írni és olyan indexképet (thumbnail) választani, amely a valódi pillanatra mutat, nem pedig egy általánosra.
A tényleges téma. Nem az a kifejezés, amire rangsorolni szerettél volna, hanem az, amiről a videó valóban szól. Ez az az alap, amire a cím, a leírás és a címkék épülnek, hogy pontosan egyezzenek azzal, amit a néző látni fog.
Miért nem elég már a kulcsszó-egyeztetés?
Mert a YouTube az alapján értékel téged, hogy mi történik a kattintás után, és a kulcsszó-egyeztetés nem lát el addig. Rangsorolhatsz egy olyan kifejezésre, amely nem illik a videódhoz, de az emberek, akiket ez odavonz, az első néhány másodpercben távoznak, és ez a korai kilépés az a jel, amiben a YouTube a leginkább bízik. Egy kulcsszó, amellyel egy nem odaillő videóval „nyersz”, rosszabb, mintha egyáltalán nem lenne kulcsszavad.
A címkék (tags) a legtisztább példa erre. A YouTube évek óta hangoztatja, hogy a címkék nagyon kis szerepet játszanak a felfedezhetőségben, és ez nem változott, az elhangzott szavak, a cím és a leírás végzik a munka oroszlánrészét. Tehát egy olyan eszköz, amely leginkább a címkéket számolja és osztályozza, azt a részt optimalizálja, amelyik alig számít. A jelentésközpontú elemzés arra a részre összpontosít, amelyik valóban számít: az őszinte csomagolást párosítja a valós tartalommal, hogy a megérkező nézők azok legyenek, akik ott is maradnak.
Van azonban egy határ, amit érdemes nyíltan kimondani. Mindez nem ment meg egy olyan videót, amit senki sem akar megnézni. A videó jelentésének megértése segít abban, hogy a megfelelő emberek gyorsabban megtaláljanak egy jó videót; de nem tesz jóvá egy gyenge videót. Az erről való őszinteség is része annak, amiért ez a megközelítés működőképes marad.
Hol helyezkedik el a VidSeeds.ai a jelentésközpontú videó-intelligenciában?
A VidSeeds.ai magát a videót elemzi még a feltöltés előtt, a beszédet, a jeleneteket, az érzelmi csúcspontokat, a jelentést, majd ezek alapján címeket, időbélyeges leírást, címkéket, fejezeteket és egy olyan indexképet tervez meg, amely a felvétel valós tartalmán alapul. Ezt megteszi a YouTube-ra, és ha ott is publikálsz, a TikTokra, Instagramra, Facebookra, LinkedInre és X-re is, 85 nyelven. A multimodális elemzés az a rész, amely először beolvassa a tartalmat; az általa javasolt indexkép-kockák a saját videódból származnak, így az arc és a pillanat valódi.
Mindent átnézhetsz és szerkeszthetsz, mielőtt bármi is publikálásra kerülne, semmi sem élesedik a jóváhagyásod nélkül. Nem generál és nem vág videót, és nem fog olyan csalit (hook) kitalálni, amit a felvétel nem tud alátámasztani. Ez egy független alternatívája a vidIQ-nak és a TubeBuddy-nak, azzal az egyetlen különbséggel, hogy magát a videót olvassa be, mielőtt egyetlen szót is leírna a metaadatokból. Ingyenesen elindulhatsz 30 Seeddel, bankkártya megadása nélkül.
Gyakran Ismételt Kérdések
Mi az a videó-intelligencia?
A videó-intelligencia a videó valós tartalmának szoftveres elemzése, az elhangzottak leirata, a képernyőn látható jelenetek, az érzelmi csúcspontok és az átadott lényeg, nem pedig csak a körülötte lévő cím, leírás és címkék vizsgálata. A jelentésközpontú videó-intelligencia a felvételből indul ki, és a metaadatokat olyan dologként kezeli, amelynek őszintén egyeznie kell azzal.
Mi a különbség a kulcsszó-eszközök és a jelentésközpontú elemzés között?
A kulcsszó-eszközök a videó köré írt szöveget olvassák és értékelik; a jelentésközpontú elemzés magát a videót olvassa be. A különbség akkor mutatkozik meg, amikor a csomagolás és a tartalom eltér egymástól, a kulcsszó-elemzés nem tudja kiszúrni ezt az eltérést, mert soha nem nézett bele a videóba, míg a tartalomelemzés ott kezdődik.
Mit jelent a multimodális elemzés?
A multimodális elemzés a videóból származó egynél több információs csatornát használ egyszerre, a hangot (beszéd), a képet (jelenetek) és az érzelmi csúcspontok időzítését, nem csak a szavakat. Ezen jelek kombinálása lehetővé teszi, hogy az eszköz megértse, miről szól valójában a videó, nem csak azt, hogy mi van ráírva címkeként.
Generál videókat a VidSeeds.ai?
Nem. A VidSeeds.ai egy már meglévő videódat elemzi a feltöltés előtt, és elkészíti a tartalomhoz illő metaadatokat és indexképet, amelyeket neked kell jóváhagynod. Nem generál, nem vág és nem tárhelyez videókat, az automatikus klipek pedig a meglévő felvételeidből kerülnek kivágásra, nem pedig újonnan jönnek létre.
Számít még a kulcsszó-optimalizálás a YouTube-on?
Egy kicsit igen, de csak azért, hogy a megfelelő keresésre találjon rá a rendszer. Tedd azt a kifejezést, amit a néző valóban beírna, a címed elejére és egyszer a leírásodba, majd állj meg. A YouTube nagyon kis súlyt fektet a címkékre, és leginkább a nézők megtartása (retention) alapján ítél meg téged, így a videóhoz illő őszinte csomagolás sokkal többet számít, mint a kulcsszavak sűrűsége.