Video Intelligence Is Moving From Keywords to Meaning, Here's What That Means
Dati, ang video intelligence ay nangangahulugan lang ng pagbasa sa mga title at tag. Ang pagbabago ngayon ay ang pagbasa sa mismong video, ang pananalita, mga eksena, at kahulugan, bago ka pa magsulat ng anumang metadata. Narito kung paano gumagana ang meaning-first analysis.
Ni VidSeeds.ai Team
Ang video intelligence ay ang proseso kung saan talagang iniintindi ng software ang isang video, kung ano ang sinasabi nito, ano ang ipinapakita nito, at tungkol saan ito, sa halip na manghula lang base sa title at mga tag na nakalagay dito. Ang pagbabagong nangyayari ngayon ay ang paglipat mula sa pangalawang uri patungo sa una: dati, binabasa lang ng mga tool ang metadata, ngunit ngayon ay binabasa na nila ang mismong footage. Mahalaga ito dahil pinakikinggan na ng YouTube ang iyong mga binibigkas na salita at pinapanood ang ginagawa ng mga manonood pagkatapos nilang mag-click, kaya ang packaging na epektibo ay ang packaging na tapat na tumutugma sa mismong nilalaman ng video.
Nagpapatakbo ako ng isang Russian nature channel, at sa loob ng maraming taon ay nag-optimize ako ng mga upload sa lumang paraan, pipili ng keyword, ipipilit ang title sa keyword na iyon, at aasang magra-rank. Ang natutunan ko sa mabagal na paraan ay halos walang naitutulong ang mga keyword game na ito, at ang trabahong talagang nagdala ng mga view ay ang nakababagot na bahagi: ang paggawa sa title na tapat na naglalarawan kung ano ang nasa loob ng video. Iyan ang esensya ng "meaning-first." Hindi ito isang matalinong trick kundi isang mas mahigpit na pamantayan.
Ano ang video intelligence?
Ang video intelligence ay ang pagsusuri ng software sa totoong nilalaman ng isang video, ang transcript ng sinasabi, ang mga eksena sa screen, ang emosyonal na daloy, at ang puntong gustong iparating ng buong video. Binabasa ng isang keyword tool ang text sa paligid ng video. Ang isang meaning-first tool naman ay binabasa ang mismong video. Ang pagkakaiba ay makikita sa sandaling hindi magtugma ang iyong packaging at ang iyong content: hindi kayang mapansin ng keyword analysis ang hindi pagtutugmang iyon dahil hindi nito kailanman tiningnan ang loob ng video, habang ang content analysis naman ay doon mismo nagsisimula.
Karamihan sa mga lumang creator tool, ang mga nagbibigay ng grado sa iyong title at nagbibilang ng iyong mga tag, ay gumagana lang gamit ang metadata. Kapaki-pakinabang ang mga ito para sa mabilisang pagsusuri, ngunit inilalarawan lang ng mga ito ang label sa lata, hindi ang mismong laman nito. Ang mas bagong diskarte ay itinuturing ang footage bilang ang pinagmumulan ng katotohanan at ang metadata naman bilang isang paglalarawan na kailangang patunayan ang halaga nito.
Paano naiintindihan ng AI ang kahulugan ng isang video?
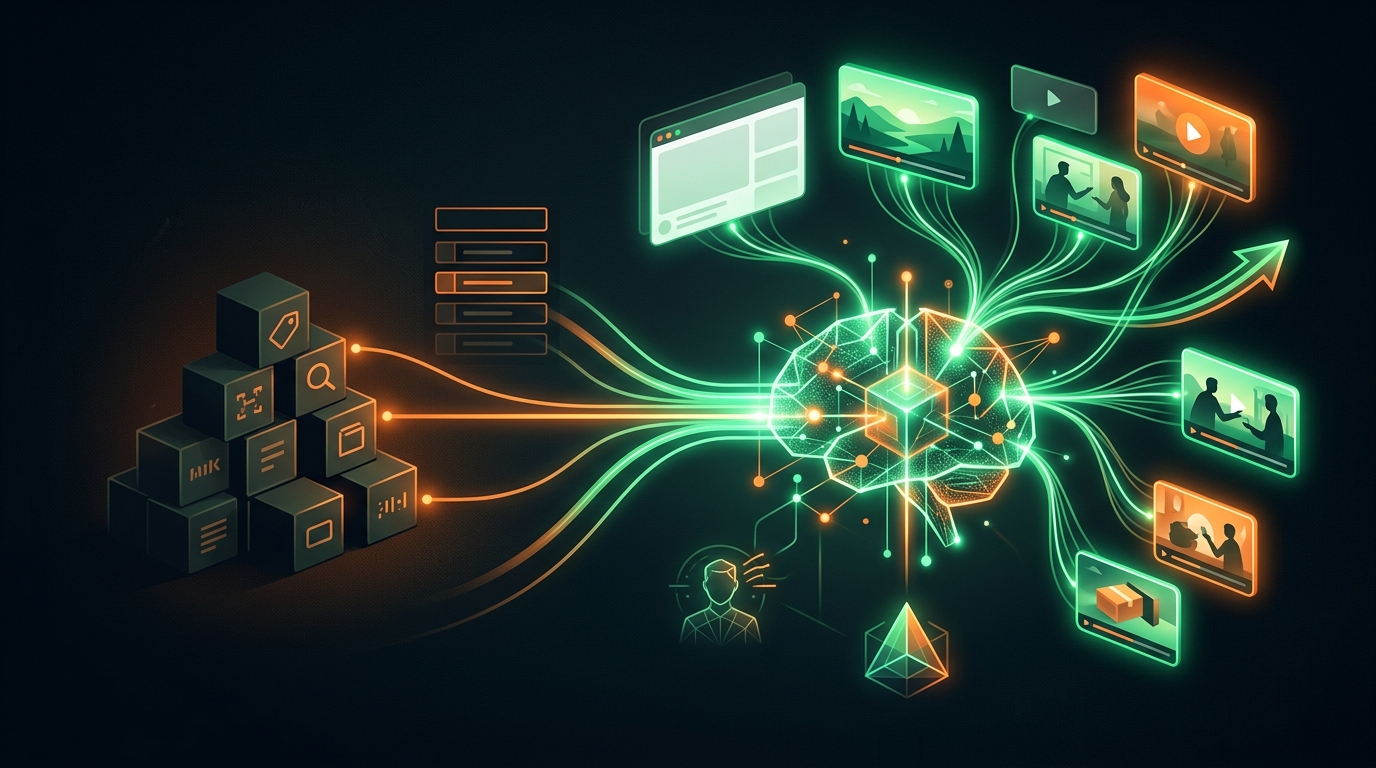
Binabasa nito ang video sa paraang gumagamit ng iba't ibang pandama nang sabay-sabay: isinusulat nito ang transcript ng pananalita, tinitingnan ang mga frame, at pinapansin kung kailan tumataas at bumababa ang enerhiya. Karaniwan itong tinatawag na multimodal analysis, ang "multimodal" ay nangangahulugan lang na gumagamit ito ng higit sa isang channel ng impormasyon (ang audio, ang larawan, at ang timing), hindi lang ang mga salita. Mula sa mga signal na iyon, bumubuo ito ng larawan kung ano talaga ang video: ang tanong na sinasagot nito, ang rurok na tinutungo nito, at kung para kanino ito.
Narito ang ilang konkretong bagay na nagagawa ng pagsusuring ito, gamit ang mismong content sa halip na listahan ng mga keyword:
Isang transcript na may mga timecode. Ang pag-alam kung kailan sinabi ang isang bagay ang nagbibigay-daan sa isang tool na magmungkahi ng mga tapat na chapter at kumuha ng tamang clip, sa halip na mag-imbento ng istrukturang wala naman sa footage.
Ang emosyonal na hugis. Karamihan sa mga video ay may rurok, ang pagbubunyag, ang punchline, ang plot twist, at ang pagtukoy kung saan ito nagaganap ay tumutulong sa iyong magsulat ng title at pumili ng thumbnail frame na nakaturo sa totoong highlight sa halip na sa isang generic na bahagi.
Ang aktwal na paksa. Hindi ang pariralang inaasahan mong mag-rank, kundi ang paksa na talagang tinatalakay sa video. Iyan ang pundasyon kung saan binuo ang title, description, at mga tag, para tumugma ang mga ito sa kung ano ang makikita ng manonood.
Bakit hindi na sapat ang keyword matching ngayon?
Dahil binibigyan ka ng YouTube ng grado batay sa kung ano ang nangyayari pagkatapos ng click, at hindi nakikita ng keyword matching ang bahaging iyon. Maaari kang mag-rank para sa isang term na hindi naman angkop sa iyong video, ngunit ang mga taong dumarating dahil doon ay aalis din sa unang ilang segundo pa lang, at ang maagang pag-alis na iyon ang signal na pinakapinagkakatiwalaan ng YouTube. Ang keyword na "napagtagumpayan" mo gamit ang isang hindi tugmang video ay mas masahol pa sa walang keyword.
Ang mga tag ang pinakamalinaw na halimbawa nito. Maraming taon nang sinasabi ng YouTube na napakaliit ng papel ng mga tag sa pagtuklas ng video (discovery), at hindi iyon nagbago, ang iyong mga binibigkas na salita, title, at description ang gumagawa ng mabigat na trabaho. Kaya ang isang tool na halos nagbibilang at nagbibigay-grado lang sa mga tag ay nag-o-optimize sa bahaging halos walang silbi. Ang meaning-first analysis naman ay nagtutuon ng pansin sa bahaging talagang mahalaga: ang pagtutugma ng tapat na packaging sa totoong content, para ang mga manonood na darating ay ang mga manonood na mananatili.
May limitasyon na dapat nating linawin. Walang anuman sa mga ito ang makakapagligtas sa isang video na ayaw namang panoorin ng mga tao. Ang pag-unawa sa kahulugan ng isang video ay tumutulong sa mga tamang tao na mahanap ang isang magandang video nang mas mabilis; hindi nito ginagawang maganda ang isang mahinang video. Ang pagiging tapat tungkol dito ay bahagi ng dahilan kung bakit epektibo ang diskarteng ito.
Paano nakakatulong ang VidSeeds.ai sa meaning-first video intelligence?
Sinusuri ng VidSeeds.ai ang mismong video bago mo pa ito i-upload, ang pananalita, mga eksena, emosyonal na daloy, at kahulugan, at pagkatapos ay gumagawa ng draft ng mga title, description na may mga timestamp, tag, chapter, at thumbnail na nakabatay sa kung ano talaga ang nasa footage. Ginagawa nito iyon para sa YouTube at, kung nagpa-publish ka rin doon, para sa TikTok, Instagram, Facebook, LinkedIn, at X, sa 85 na wika. Ang multimodal analysis ang bahaging nagbabasa muna ng content; ang mga thumbnail frame na iminumungkahi nito ay nagmumula sa sarili mong video, kaya totoong mukha at totoong sandali ang ipinapakita nito.
Ikaw ang magre-review at mag-e-edit ng lahat bago i-publish ang anuman, walang nagiging live nang walang pahintulot mo. Hindi ito gumagawa o nag-e-edit ng iyong video, at hindi ito mag-iimbento ng hook na hindi kayang panindigan ng footage. Ito ay isang independiyenteng alternatibo sa vidIQ at TubeBuddy, na may iisang pagkakaiba: binabasa nito ang mismong video bago ito magsulat ng kahit isang salita ng metadata. Maaari kang magsimula nang libre gamit ang 30 Seeds, walang card na kailangan.
Mga Madalas Itanong (FAQs)
Ano ang video intelligence?
Ang video intelligence ay ang pagsusuri ng software sa totoong nilalaman ng isang video, ang transcript ng sinasabi, ang mga eksena sa screen, ang emosyonal na daloy, at ang puntong ipinaparating, sa halip na sa title, description, at mga tag lang sa paligid nito. Ang meaning-first video intelligence ay nagsisimula sa footage at itinuturing ang metadata bilang isang bagay na kailangang tapat na tumugma dito.
Ano ang pagkakaiba ng mga keyword tool at meaning-first analysis?
Binabasa ng mga keyword tool ang text sa paligid ng video at binibigyan ito ng grado; ang meaning-first analysis naman ay binabasa ang mismong video. Ang pagkakaiba ay makikita kapag hindi nagtugma ang packaging at ang content, hindi kayang mapansin ng keyword analysis ang hindi pagtutugmang iyon dahil hindi nito kailanman tiningnan ang loob ng video, habang ang content analysis naman ay doon mismo nagsisimula.
Ano ang ibig sabihin ng multimodal analysis?
Ang multimodal analysis ay gumagamit ng higit sa isang channel ng impormasyon mula sa isang video nang sabay-sabay, ang audio (pananalita), ang larawan (mga eksena), at ang timing ng emosyonal na daloy, sa halip na mga salita lamang. Ang pagsasama-sama ng mga signal na ito ay nagbibigay-daan sa isang tool na maunawaan kung tungkol saan talaga ang video, hindi lang kung ano ang nakasulat sa label nito.
Gumagawa ba ng mga video ang VidSeeds.ai?
Hindi. Sinusuri ng VidSeeds.ai ang isang video na mayroon ka na bago mo ito i-upload, at gumagawa ito ng draft ng metadata at thumbnail na tumutugma sa content nito para aprubahan mo. Hindi ito gumagawa, nag-e-edit, o nagho-host ng video, at ang mga auto-clip ay kinukuha mula sa iyong umiiral na footage, hindi nililikha mula sa wala.
Mahalaga pa ba ang keyword optimization sa YouTube?
Nang kaunti, at para lang tumugma sa tamang paghahanap (search). Ilagay ang pariralang talagang itatype ng isang manonood malapit sa unahan ng iyong title at isang beses sa iyong description, pagkatapos ay huminto na doon. Napakaliit ng timbang na ibinibigay ng YouTube sa mga tag at hinuhusgahan ka nito halos sa retention o tagal ng panonood, kaya ang tapat na packaging na angkop sa video ay mas mahalaga kaysa sa dami ng keyword (keyword density).